
お客様にゼロからの手組みを強いることなく、最短数週間でAIを実業務へ稼働させるTeradataの独自アプローチ「5ステップ・コンテキストエンジニアリング」をご紹介します。
なぜ、プロンプトエンジニアリングだけでは限界なのか?
多くの企業が、AIを賢くするために「プロンプトエンジニアリング」に労力を割いています。しかし、エンタープライズ規模のAI活用において、このアプローチには2つの致命的な限界があります。
一つは、「文脈なきAIの暴走(ハルシネーション)」です。生データだけをAIに渡しても、「売上は受注ベースか請求ベースか」といった社内の当たり前(コンテキスト)を知らなければ、AIは推測で誤った回答を生成します。
もう一つは、「個別最適によるAIのサイロ化」です。生産計画、在庫最適化、調達リスク管理と、部門ごとに個別のAIへ業務知識を教え込むアプローチは、組織内で知識の重複や不整合を生み出します。結果として、AI同士が連携できない分断されたシステムが出来上がってしまうのです。
成果から逆算するTeradataの「5ステップ・コンテキストエンジニアリング」
この課題を解決するため、Teradataはデータ基盤の構築から始めるのではなく、解決すべきビジネス課題から逆算してAIの前提条件を整える、確実なプロセスを提供します。
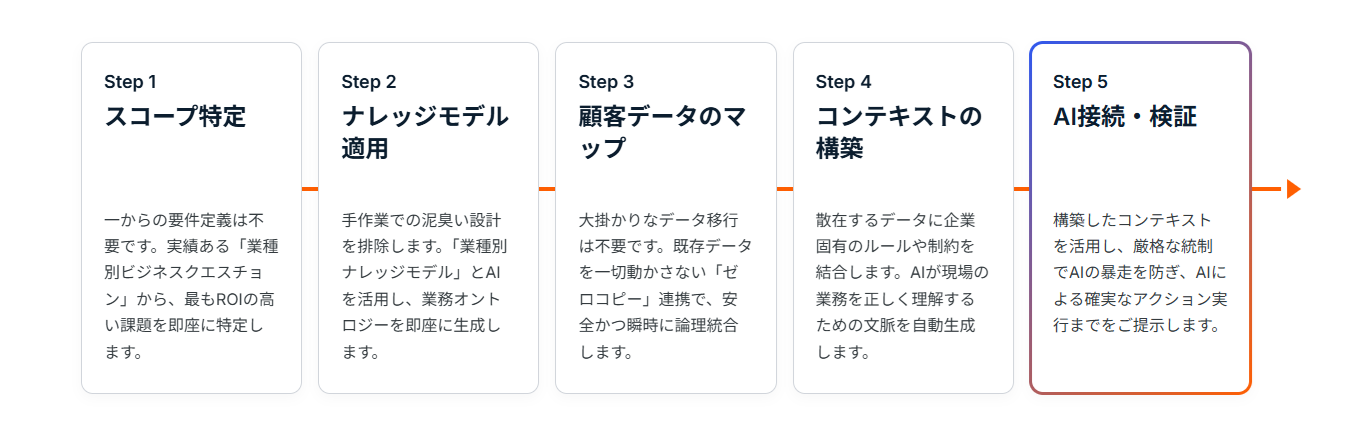
Step 1: スコープ特定
白紙の要件定義は行いません。実績ある「業種別ビジネスクエスチョン」から、最もROIの高い「問い」を即座に特定します。
Step 2: 必要なデータと業務知識の特定
業界知識を起点に、その問いに答えるために不可欠なデータと社内ルールの不足箇所を洗い出します。
Step 3: 顧客データのマップ
大掛かりなデータ移行を伴わない「ゼロコピー」連携により、既存データを動かさずに安全かつ瞬時に論理統合します。その上で、業種別ナレッジモデル(業界標準のエンティティや指標の体系)にマッピングします。
Step 4: コンテキストの構築
散在するデータに企業固有のルールや制約を結びつけ、AIが現場業務を正しく理解するための「統制された文脈」を自動生成します。
Step 5: AI接続・検証
構築したコンテキストを活用し、厳格なガードレールでAIの暴走を防ぎながら、実データに基づく確実なアクション実行を検証します。
圧倒的なスピードの裏側:ゼロから作らない「業種別ナレッジモデル」
なぜ、Teradataはこれほど短期間でコンテキストを構築できるのでしょうか。それは、お客様の物理データからLLMを使ってボトムアップで手探りに意味を抽出するような「DIY型」のアプローチを取らないからです。
私たちは、40年以上の知見が結晶化した「業種別ナレッジモデル(業界標準のエンティティや指標の体系)」を最初から保持しています。これを上記Step 3で適用することで、手作業による泥臭い設計工程を劇的にスキップできます。
実際、ある大手製造業のお客様では、このアプローチにより、10個のビジネスクエスチョンに対するコンテキストをわずか1ヶ月で構築し、価値提供までの時間を大幅に短縮することに成功しています。
コンテキストを「使い捨て」から「全社の共有資産」へ
さらに重要なのは、構築したコンテキストを決して使い捨てにしないことです。
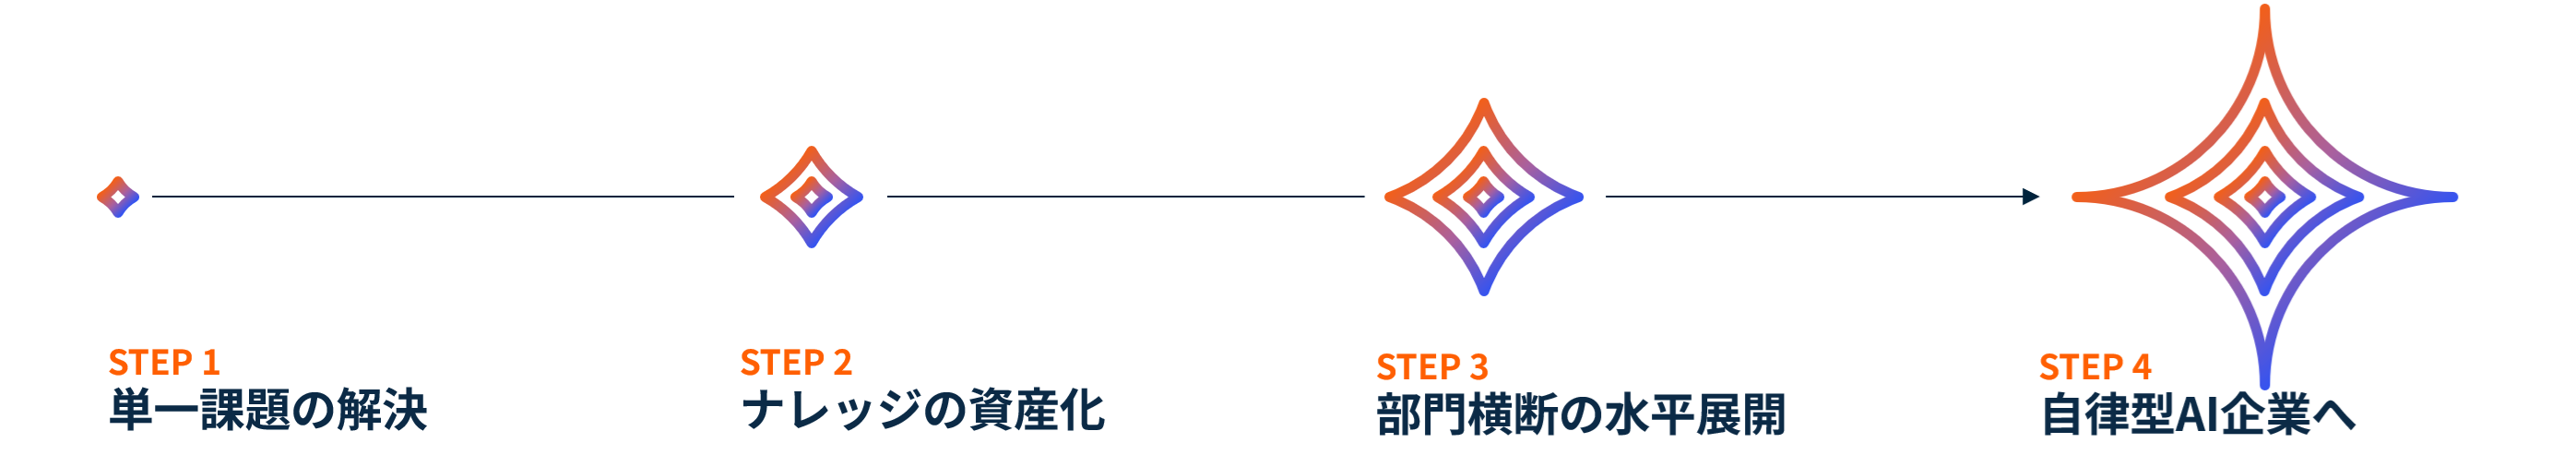
たとえば、最初の生産計画AIのために作ったコンテキストは、次の在庫最適化AIを構築する際の強固な土台となります。新しいユースケースでは、既存のコンテキストを再利用し、必要な「差分」のデータと知識を追加するだけで済みます。ユースケースが増えるほど導入スピードが加速し、ビジネス価値が相乗的に高まる。これが、Teradataが目指す「エンタープライズコンテキスト」の育成であり、自律型AI企業への唯一の道筋です。
NEXT STEP:RFPを書く前に、まずは「問い」を見つけるセッションから
AIツールの機能比較(RFP)に膨大な時間を費やすのはもう終わりにしましょう。
Teradataの「ビジネスクエスチョン・ディスカバリー・セッション(無償)」では、機能要件の羅列ではなく、貴社のビジネスに最も劇的なインパクトをもたらす「切迫課題(問い)」を特定し、AI実稼働に向けた最短のロードマップをご提示します。
手組みの泥沼を回避し、確実な事業成果(ROI)を創出するための第一歩を、Teradataと共に踏み出しませんか。
ビジネスクエスチョン・ディスカバリー・セッションのお問合せはお気軽にこちらからご連絡ください。