概要
データ変換とは、ある形式、構造、スキーマから別の形式へデータを変換するプロセスであり、生データをクレンジング、標準化、集約、マッピングし、一貫性のある高精度な形態に変換し、下流の分析、ビジネスインテリジェンス(BI)、人工知能(AI)モデルが信頼できるようにするプロセスです。
現代の企業環境では、生データは非構造化の運用ログ、トランザクショナルレコード、IoTセンサーテレメトリー、半構造化JSONペイロードなど、多様な構造の断片化されたシステムから送られてきます。これらの異なるストリームが洗練されなければ、データのサイロ化や下流の分析パイプラインの崩壊、機械学習システムへのバイアスの導入などが生まれます。調査データによると、データエンジニアリングチームは運用サイクルの最大80%を高付加価値モデリングではなく、手動のデータ準備や変換に日常的に割いています。
自動化されスケーラブルなデータ変換パイプラインを構築することで、組織は生のマルチソース入力をエンタープライズグレードのデータ資産に昇格させます。これらのクリーンで構造化された資産は、リアルタイムダッシュボード、予測アルゴリズム、生成AIの特徴エンジニアリング、規制報告を支えます。2025年第2四半期の「The Forrester Wave™: Data Management for Analytics Platforms」でリーダーとして認められ、データ変換、データ統合、プラットフォーム内分析で最高得点(5/5)を獲得したTeradataプラットフォームは、Teradataデータベースの標準的な分析機能を用いて複雑なトランスフォーメーションワークロードを大規模に処理するための高性能基盤を提供します。
主なポイント
- データ変換は、生データを標準化し再構築し、分析、BI、機械学習モデルのための統一的で高品質な資産にします。
- 基礎的なパイプラインは、収集、クレンジング、正規化、集約、マッピングの5つの主要なステップを踏みます。
- 現代のクラウドアーキテクチャでは、ELT(抽出、ロード、変換)をますます重視し、膨大なデータベース内の計算能力を活用してTeradata Cloud内で直接データを変換しています。
- 柔軟なツールは、オープンソース言語(Python、R、SQL)から専用のELTフレームワーク(例えばdbt CloudのTeradata)、そしてTeradata Databaseのネイティブなデータベース内機能まで多岐にわたります。
- 高インパクトの変革は、財務コンプライアンス、医療の相互運用性、小売顧客分析、エグゼクティブBIといった重要なワークフローを支えています。
データ変換プロセス
データ変換プロセスは、未精錬の生データを構造化され信頼性の高いリソースに変換する複数の調整されたタスクを含みます。個々の実装は企業のアーキテクチャやビジネス目標に依存しますが、ほとんどの高性能トランスフォーメーションワークフローはデータ変換のコアステップを踏みます。各ステップは、レコードをソースシステムから分析対象へと移動するより広範な データパイプライン 内で行われます。
1. データ収集
生データはCRMデータベース、ERPシステム、Web API、クラウドストレージ、ストリーミングプラットフォームなどのソース環境から抽出されます。これらの入力は異種形式(SQLテーブル、CSV、JSON、XML)で届くため、初期の収集が下流処理の基盤となる接続を確立します。このように異種ソースを統合することで、企業規模での プラットフォーム内下流変換 が可能になります。
2. データクレンジング
クレンジングは生データセットの構造的なノイズやエラーを解決します。この段階では、自動ルールが不完全なフィールドを特定し修正し、重複レコードを排除し、矛盾する値を照合し、欠落データを処理します。自動スクラブと検証プロトコルがパイプラインの信頼性をどのように守るかを探りたい方は、 データクレンジングとは何かに関する詳細なガイドをご覧ください。
3. データ正規化
正規化は異なるシステム間でデータを標準化し、正確に比較・結合できるようにします。一般的な方法には、タイムスタンプのISO標準への再フォーマット、通貨値の変換、 機械学習のための数値範囲の再スケーリング (例:最小最大スケーリングやzスコア正規化)、コード定義の整合(例:「米国」「米国」「米国」「米国」を単一の標準にマッピングする)などがあります。
4. データ集約
アグリゲーションは、詳細な記録レベルのデータをまとめ、 レポートやエグゼクティブダッシュボード向けにまとめられた統計にまとめます。運用には、日々の売上総額の計算、地域ごとの顧客応答時間の平均化、30日間のローリング取引量の計算が含まれます。
5. データマッピング
データマッピングは、ソーススキーマ属性と宛先データベースターゲット間の正確なフィールドレベルの関係を定義します。マッピングは、複雑なシステム統合や データ移行 プロジェクトにおいて、データフィールドが対応する正確な目的地にルーティングされることを保証する設計図を確立します。
データ変換手法の概要
パイプラインに適したデータ変換方法を選ぶには、以下でそれらのコア機能、主要なユースケース、運用の複雑さを比較してください。
| 変換法 | その役割 | いつ使うべきか | 例 | 複雑さ |
|---|---|---|---|---|
| データクレンジング | エラー、重複、無効なレコードを除去します | 信頼できない生データを読み込んだり解析したりする前に | 綴り間違いの訂正と重複した顧客IDの削除 | 低〜中 |
| データ正規化 | フォーマット、範囲、メートル法のスケールを標準化 | データベース、BI、またはAIモデルの機能セット準備 | 日付フォーマットをYYYY-MM-DDに標準化するか、0から1の間にスケーリングする | メディア |
| データ集約 | 細かい記録をビジネス指標にまとめる | エグゼクティブダッシュボード、KPI、レポート層の構築 | 時間あたりの店舗取引を週ごとの地域収益にまとめる | 低め |
| データマッピング | ソースフィールドをターゲットスキーマ属性に接続します | システム統合、スキーマ統合、移行 | CRMのcust_numとERPのAccount_IDをマッチングする | メディア |
| データエンリッチメント | 外部または文脈データポイントの付足 | 分析の深さと顧客セグメンテーションの向上 | ユーザープロファイルに人口統計や地理的属性を追加する | 中〜高 |
本番環境では、エンジニアリングチームがこれらの手法を広範な データワークフロー のオーケストレーションモデルの中で組み合わせ、パイプラインの整合性を維持することがよくあります。
ETLおよびELTにおけるデータ変換
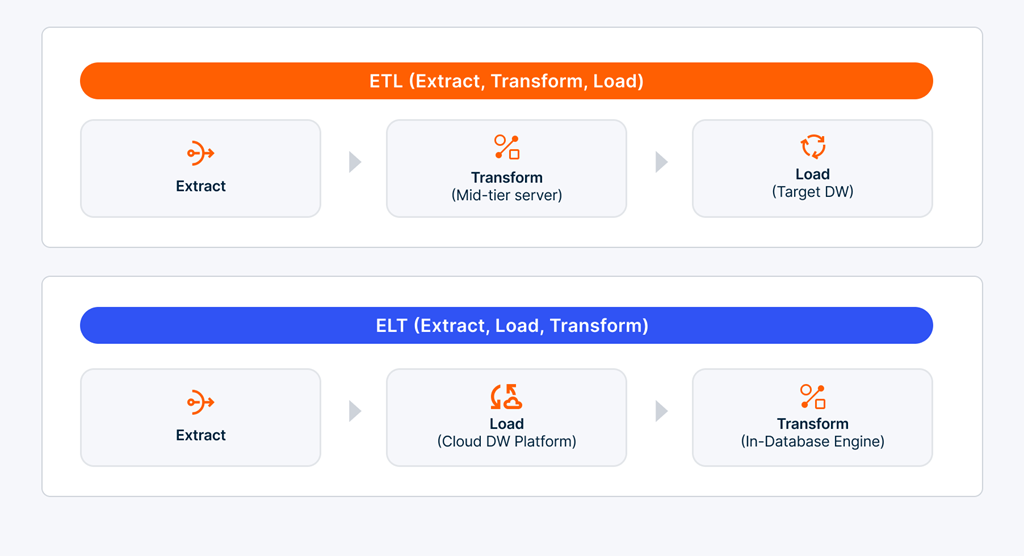
データ変換は、 データ抽出・変換・ロード(ETL) および抽出・ロード・変換(ELT)アーキテクチャの中核要素であり、これらは現代 のデータ統合の基盤となるパターンです。
従来のETLアプローチ
従来のETLパイプラインでは、データ変換はソースシステムからの抽出後、ターゲットデータウェアハウスへのロード前に中間ステージングサーバー上で行われます。
- 強み: 生データが永久保存される前に厳格なデータ品質、ガバナンス、コンプライアンスフォーマットを確保します。
- 最適な用途: レガシーなオンプレミスアーキテクチャ、厳格な事前ロード匿名化が必要な機密データセット、そして厳格なコンプライアンスフレームワーク。
現代のELTアプローチ
クラウドデータプラットフォームの進化に伴い、ELTはエンタープライズ分析や AI機能準備の主流アーキテクチャとして台頭しています。ELTパイプラインでは、生データは元の形式で即座にクラウドデータウェアハウスに抽出・ロードされます。変換は、ネイティブの並列化された計算パワーを用いてデータプラットフォーム内で直接実行されます。
- 強み: 高度なパフォーマンススケーラビリティ、高速なロード時間、半構造化データ向けの柔軟なスキーマオンリード機能を提供します。
- 最適な用途: 大量のクラウド分析、非構造化/半構造化データストリーム、リアルタイム分析、高度なAI/MLフィーチャーエンジニアリング。
ETLかELTのどちらを選ぶかは、データ量、パイプラインの遅延ニーズ、インフラによって異なります。複雑なエンタープライズワークフローを管理する組織は、分散クラウドネットワーク間でハイブリッドなETL/ELTタスクをシームレスに調整するためにエンドツーエンドのデータ オーケストレーション を頻繁に採用しています。
データ変換の例
実際のデータ変換を理解するために、地域の医療提供者が異なるクリニック、診断検査機関、電子カルテ(EHR)ソフトウェアにまたがって患者指標を統合している例を考えてみてください。
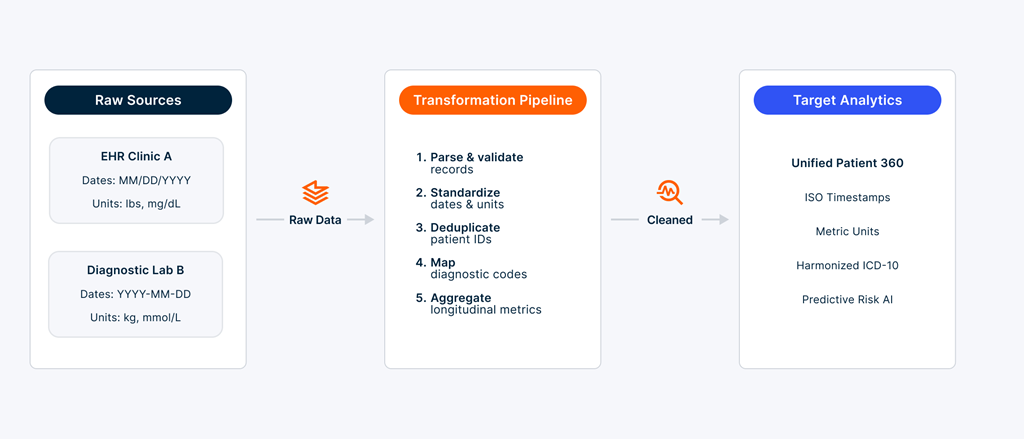
- 抽出: 生の表はクリニックA(インペリアル単位およびMM/DD/YYYY年代を用いて)およびラボB(メートル法とYYYY-MM-DD年代を使用)から抽出されます。
- クレンジングと検証: 範囲外のセンサー読み取り(例:負のパルス値)はフラグ立てられ、例外キューにルーティングされます。重複した患者エントリは統合されます。
- 正規化: すべての重量値はキログラム(kg)に換算され、血糖値はmg/dLで標準化され、タイムスタンプはISO 8601に準拠しています。
- マッピングと集約: 診断コードは普遍的なICD-10分類にマッピングされ、個々の臨床受診は単一の縦断的患者プロファイルに集約されます。
この成果は、臨床医やデータサイエンティストに患者健康のクリーンで統一されたビューを提供し、早期疾患介入や生成AI臨床アシスタントのための予測分析を直接支えています。
データ変換のベストプラクティス
- 明確なビジネス目標を設定する: スキーマ設計前にエンドユーザーの要件を定義し、不要な計算負荷を回避しましょう。
- 早期にデータガバナンスを実施する: トランスフォーメーションライフサイクル全体を通じて、厳格なデータ品質管理、監査ログ、系譜追跡を維持しましょう。
- 自動化テストの組み込み: 変換パイプライン内で自動化されたユニットテストやスキーマチェックを実装し、本番レポートに届く前に異常を発見します。
- データベース内処理の活用: スケーラブルなクラウドデータプラットフォーム内で直接変換を実行することで、コストのかかるデータ移動を最小限に抑えます。
データ変換の利点
堅牢なデータ変換戦略は、企業のデータエコシステムのあらゆる層に影響を与える基盤的な利益をもたらします。
データの品質と一貫性の向上
生データには本質的にエラー、冗長なフィールド、不一致のフォーマットが含まれています。体系的なクレンジングと正規化によりこれらの異常が除去され、事業部門間で一貫性のある高精度な入力が保証されます。高品質なデータは運用上の摩擦を減らし、コンプライアンスリスクを軽減し、単一の真実の情報源を確立します。
データ分析と意思決定の強化
変換されたデータは、データサイエンティストやビジネスアナリストが手動準備なしで高度な分析モデルを適用できるようにします。クリーンで構造化されたデータセットは、予測アルゴリズム、エグゼクティブダッシュボード、統計モデルのパフォーマンスを直接向上させます。例えば、正規化された指標を適用することで、 記述統計 や自動報告の下の計算が簡素化されます。
運用効率の向上
データ変換の自動化により、分析チームの最大80%の時間を費やす手動のデータ整理作業が不要になります。標準化された自動化されたパイプラインは、インサイト提供を加速し、処理コストを削減し、エンタープライズシステム全体でアプリケーションクエリのパフォーマンスを向上させます。
データ変換ツール
適切なソフトウェアの選択は、データ量、アーキテクチャ、スキル、そして変革がどこで行われるか(開発者向けコードスクリプトからエンタープライズクラウドプラットフォームまで)に依存します。
Teradata CloudとTeradata Databaseを用いたデータベース内分析
現代のエンタープライズアーキテクチャでは、遅延やデータ出口コストを避けるため、データストレージ層内で直接変換を実行することが優先されます。
- クラウド: マネージドクラウド展開環境として、Teradata Cloudは大規模なELT変換をネイティブに実行します。データベースは、データ準備、特徴解析、テキスト分析、ベクター生成のための並列化されたデータベース内機能を提供し、外部抽出なしでデータが存在する場所で複雑な変換を直接実行します。
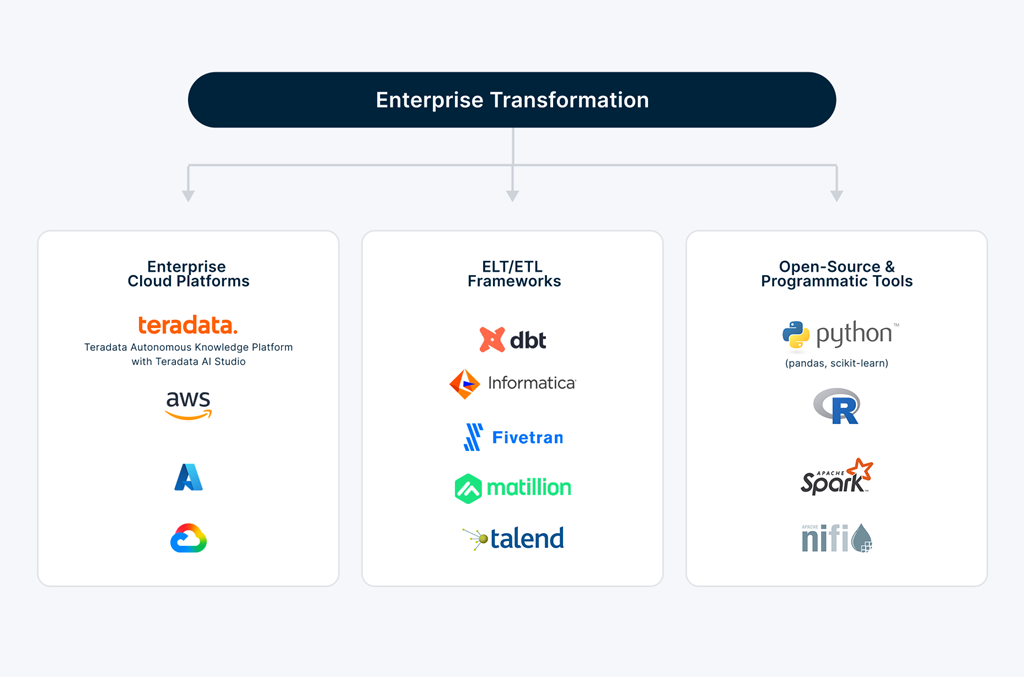
- クラウドインフラエコシステム: Teradata Cloud、Snowflake、Google BigQuery、Databricks、AWS Redshiftなどの主要なクラウドデータプラットフォームは、データベース内の計算を活用して高スループットのELTパイプラインを効率的に処理しています。
専門的なETLおよびELTフレームワーク
- DBT(データビルドツール): データチームが変換をモジュール式SQLクエリとして作成でき、現代的な分析エンジニアリングの実践をサポートします。Teradataのようなdbt Cloudの統合により、チームはエンタープライズグレードのガバナンスでバージョン管理型変換モデルを管理できます。
- Informatica、Fivetran、Matillion & Talend: マルチクラウドトポロジーにわたる複雑なデータ取り込みと変換パイプラインをオーケストレーションするための、プリビルドコネクターと自動ビジュアルインターフェースを提供します。
オープンソースおよびプログラムフレームワーク
- PythonとR: カスタム変換タスクのための細かい制御を提供します。pandasやscikit-learnのようなPythonライブラリは、特徴量エンジニアリングに強力な関数(例:MinMaxScaler、StandardScaler)を提供し、Rは統計操作に優れています。
- Apache SparkとApache NiFi: ビッグデータの変換、ストリーミングテレメトリ、高速イベントパイプラインのための分散処理能力を提供します。
業界のユースケース
データ変換は業界特有のデータアクティベーションの基盤を提供します。
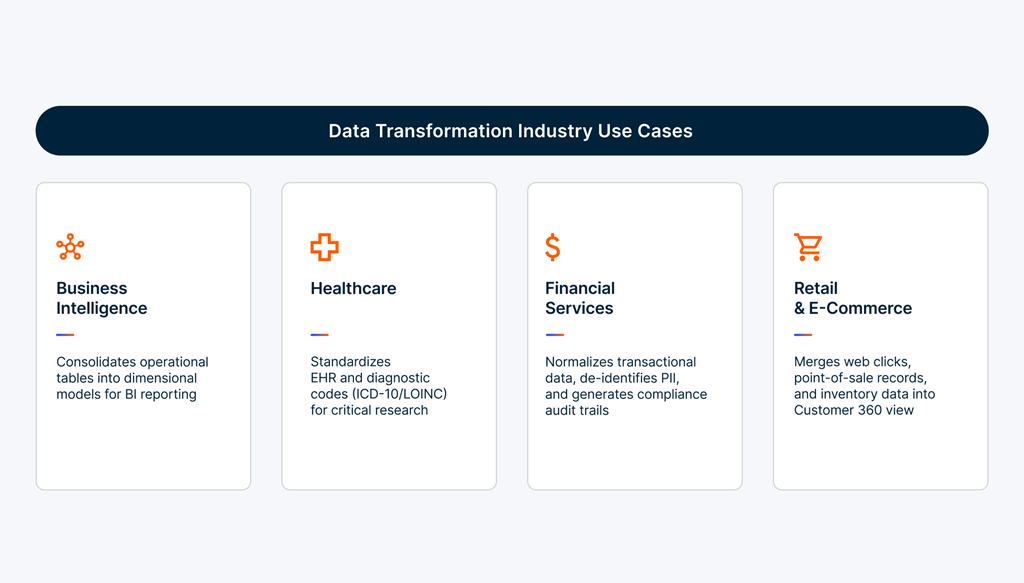
- ビジネスインテリジェンス: 生の運用ログはクレンジングされ、集約され、スタースキーマのデータマートにマッピングされ、経営陣は企業のKPIに関する正確かつリアルタイムの洞察を提供します。
- 医療およびライフサイエンス: 異なるEHRベンダーからの医療記録、検査結果、請求ファイルは標準化されたフォーマット(FHIRなど)に変換され、シームレスな臨床相互運用性と患者のアウトカム追跡を可能にします。
- 金融サービス: 金融機関は生の取引ストリームを変換し、リアルタイムで不正行為を検出し、国境を越えた通貨の通貨交換を正規化し、自動化された規制報告書を作成します。
- 小売とeコマース: 小売業者はオンラインブラウジングセッション、POS取引、サプライチェーンの更新を統合し、パーソナライズされた推薦エンジンと動的な在庫予測を活用しています。
結論
データ変換は、生の断片化されたデータを構造化され信頼性の高い資産へと変え、現代のビジネスインテリジェンス、エンタープライズ分析、AIの不可欠な基盤を形成します。マルチクラウド環境全体で企業のデータ量が加速し続ける中、効率的かつ安全に大規模に変革を行うことは重要な戦略的優位性となっています。
Teradata Cloud内のTeradata Databaseのデータベース内機能を活用することで、組織はデータが所在する場所で直接変換でき、冗長なデータ移動を排除し、パイプラインのパフォーマンスを加速させ、運用の複雑さを軽減します。データパイプラインアーキテクチャの変革方法やチームの専門知識を深める方法を探りたい方は、Teradataのデータベース内分析リソースを訪問するか、 Teradata Universityの学習パスをご覧ください。
エンタープライズの変革ワークロードを近代化する準備はできていますか?
データエンジニアリングの最大80%を手動の整理や高価な外部ステージングハードウェアに費やすのをやめましょう。ELTパイプラインをデータベース層内で直接近代化し、大規模な並列処理を解放し、クラウドの計算負荷を削減し、AI対応のデータセットをリアルタイムで提供しましょう。
Teradataのデータベース内分析ソリューションを探検 するか、 アーキテクチャデモを予約 して、Teradataプラットフォームが大量の生ストリームを大規模にエンタープライズインテリジェンスに変換する様子をご覧ください。
よくある質問
データ変換の主なタイプは何ですか?
データ変換の主なタイプは何ですか?
データ変換の主なタイプには以下が含まれます:
- 構成的変換: 既存のデータから新しい指標、計算フィールド、または集約された属性を作成します。
- 破壊的変換: 不要なフィールド、冗長なレコード、または敏感な値を除去します(例:コンプライアンスフィルタリング時に生のPIIを除外)。
- 美的変換: 電話番号、日付、住所文字列の再フォーマットなど、データフォーマットの標準化。
- 構造変換: 行を列にピボット化したり、階層的なJSONドキュメントをリレーショナルテーブルにフラット化したりといったデータベーススキーマトポロジーを再編成します。
データの変換にはどのようなリスクが伴うのでしょうか?
データの変換にはどのようなリスクが伴うのでしょうか?
データ変換パイプラインにおける主なリスクは以下の通りです:
- データの損失や破損: 誤ったマッピングルールや変換中の誤ったデータ切断は重要なレコードを上書きすることがあります。
- パフォーマンスのボトルネック: 複雑で最適化されていない変換スクリプトを大量のデータセットで実行すると、下流パイプラインの遅延やクラウド計算コストの膨大化を招きます。
- セキュリティおよびコンプライアンスの失敗: 処理中に機密記録を誤って露出させたり、必要なマスキング機能を適用しなかったりすると、ガバナンスの脆弱性が生まれます。
- スキーマドリフト: 上流のソースフォーマットに予告なしの変更があると、変換スクリプトが破損したり、ターゲットテーブルが破損したりすることがあります。
データ変換はどこから始めるべきでしょうか?
データ変換はどこから始めるべきでしょうか?
効果的なデータ変換プロセスを確立するために、以下の基礎ステップに従ってください:
- 発見とプロファイリング: 生データソースを分析し、スキーマのバリエーション、データ品質の誤差、欠損値を特定します。
- マッピングとルール定義: コードを書く前に、ビジネスルール、フィールドマッピング、変換ロジックを定義してください。
- データクレンジングと前処理: 重複を解決し、データ型を標準化し、 データクレンジングなどのツールを用いてフォーマットを検証することで生データセットをクレンジングします。
- 実行とオーケストレーション: 信頼性の高いワークフローオーケストレーションによって管理される、Teradata Cloud内のELTのようなスケーラブルなアーキテクチャを用いてデータの読み込みと変換を行います。
- 継続的なモニタリング: スキーマドリフトの追跡、出力精度の検証、長期的なデータ品質の維持のために自動パイプライン監視を実装します。