Fit_Screen
柔軟性と卓越したスケーラビリティ
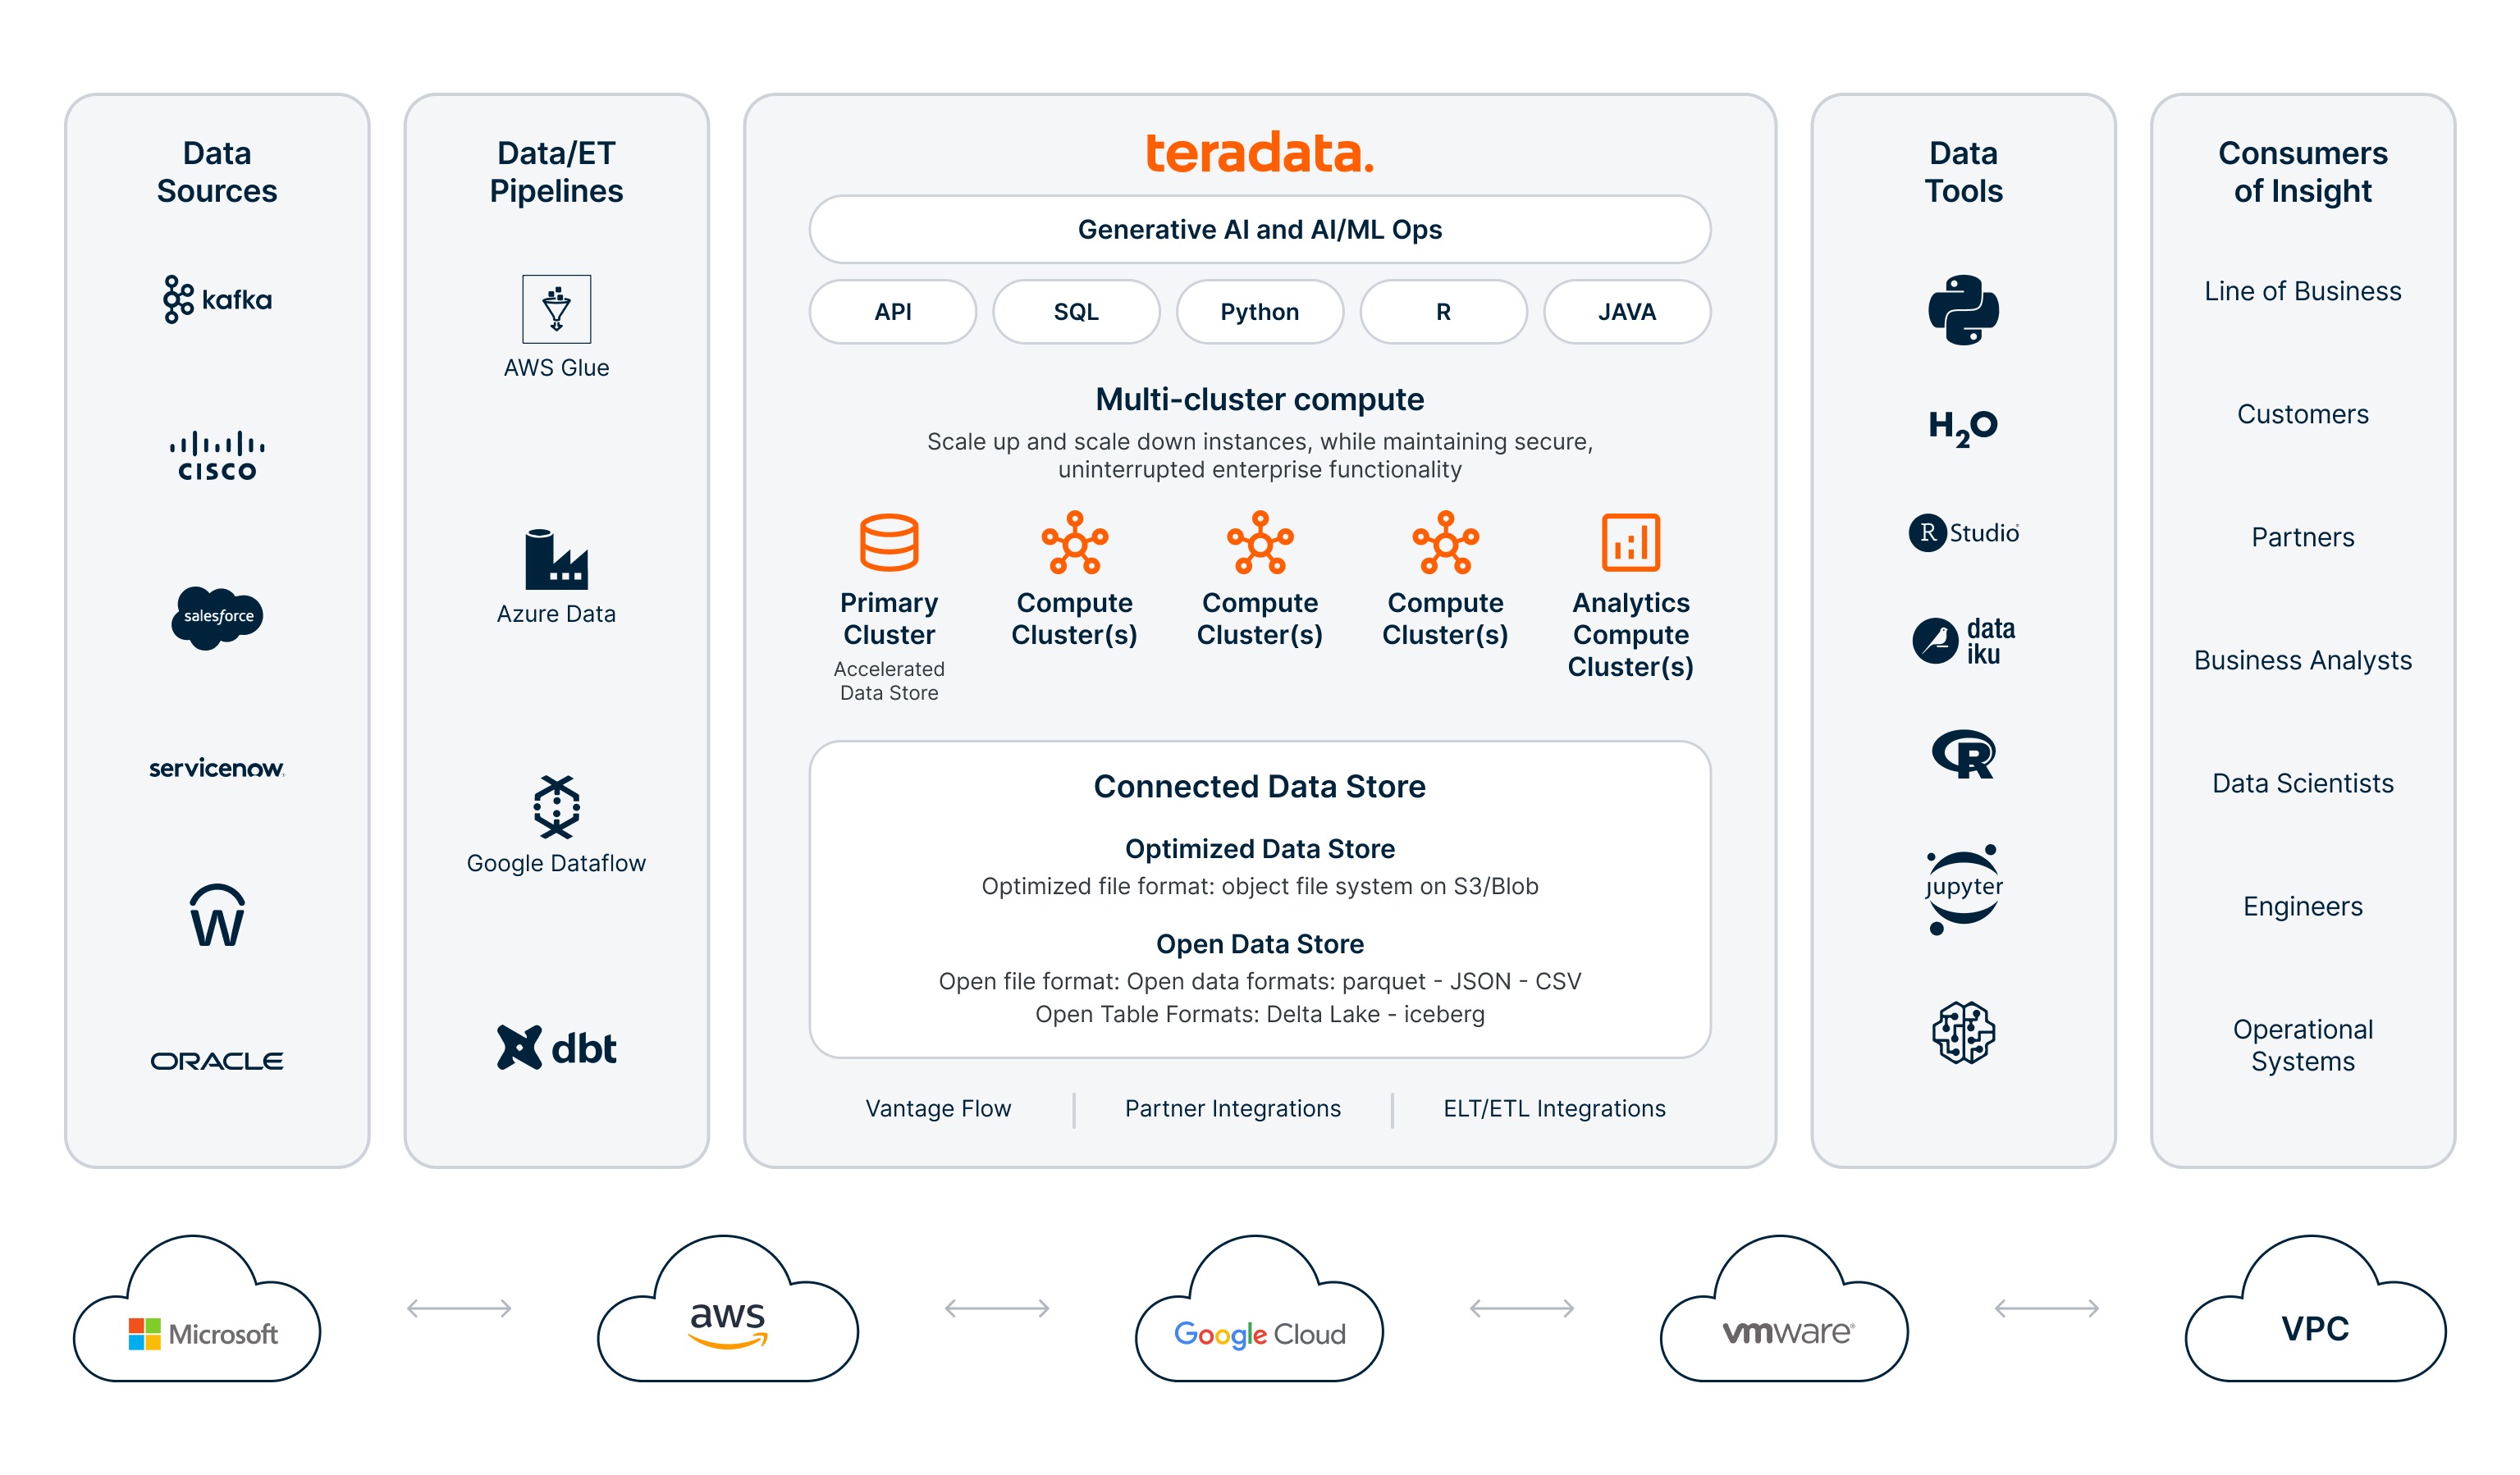
単一のオープンデータストアに対して複数のコンピュートクラスターを展開できる、比類のない柔軟性を提供。スマートスケーリング技術による動的なリソース配分により、ビジネス要件の変化に合わせてコスト効率の高い自動スケーリングを実現します。

次世代のクラウドネイティブアーキテクチャを備えたTeradataは、独立したエラスティックワークロードを実行できるように設計されています。一元化されたオブジェクトストレージを活用し、構造化、非構造化、半構造化データを含む幅広いデータタイプを収容。全社のあらゆる部門がオンデマンドで分析プロジェクトを実行し、データの潜在能力を最大限に解放できます。
単一のオープンデータストアに対して複数のコンピュートクラスターを展開できる、比類のない柔軟性を提供。スマートスケーリング技術による動的なリソース配分により、ビジネス要件の変化に合わせてコスト効率の高い自動スケーリングを実現します。
すべてのエンタープライズユーザーへ透過的なアクセスを提供し、データの精製・変換からエンドユーザー活用に向けた最適化まで、完全なデータライフサイクルを支援。全社のイノベーターが、統合プラットフォームから接続型データ基盤へとシームレスにアクセスできます。
データの安全性を確保しながら、検索可能な状態を維持。再利用に向けてデータを統合・調和させ、業務活用向けにキュレーションします。全社規模でアナリティクスを活性化し、AI主導の未来への歩みを加速させます。
AIを全社規模で展開するための俊敏性と柔軟性を備えた、真にモダンで将来にわたって陳腐化しないデータ戦略により、AIユースケースを力強く推進します。
データ製品やドメインを横断した効率的な取り込み・キュレーション・活用アクセスにより、部門間の協働を促進
現代のデータドリブンなビジネス環境において、データ資産の潜在能力を解き放つ鍵は部門間のコラボレーションです。オープンでコネクテッドなデータ基盤は、開発プロセスを合理化し、多様な事業部門間の協働を活性化。インフラ管理ではなくデータ資産の活用に集中することで、ビジネス価値の創出と市場競争優位性の確立を後押しします。
コネクテッドデータ基盤は、異なるレベルのデータキュレーションや再利用性を提供する複数のレイヤー(ゾーン)で構成され、最適化ストレージとオープンストレージの組み合わせによってアーキテクチャの柔軟性を支えます。
データ製品とは、セマンティクス、コスト、品質、可用性、パフォーマンスを定義した詳細なメタデータを伴い、特定目的のために精緻に構築・プロビジョニングされた包括的なデータエンティティです。
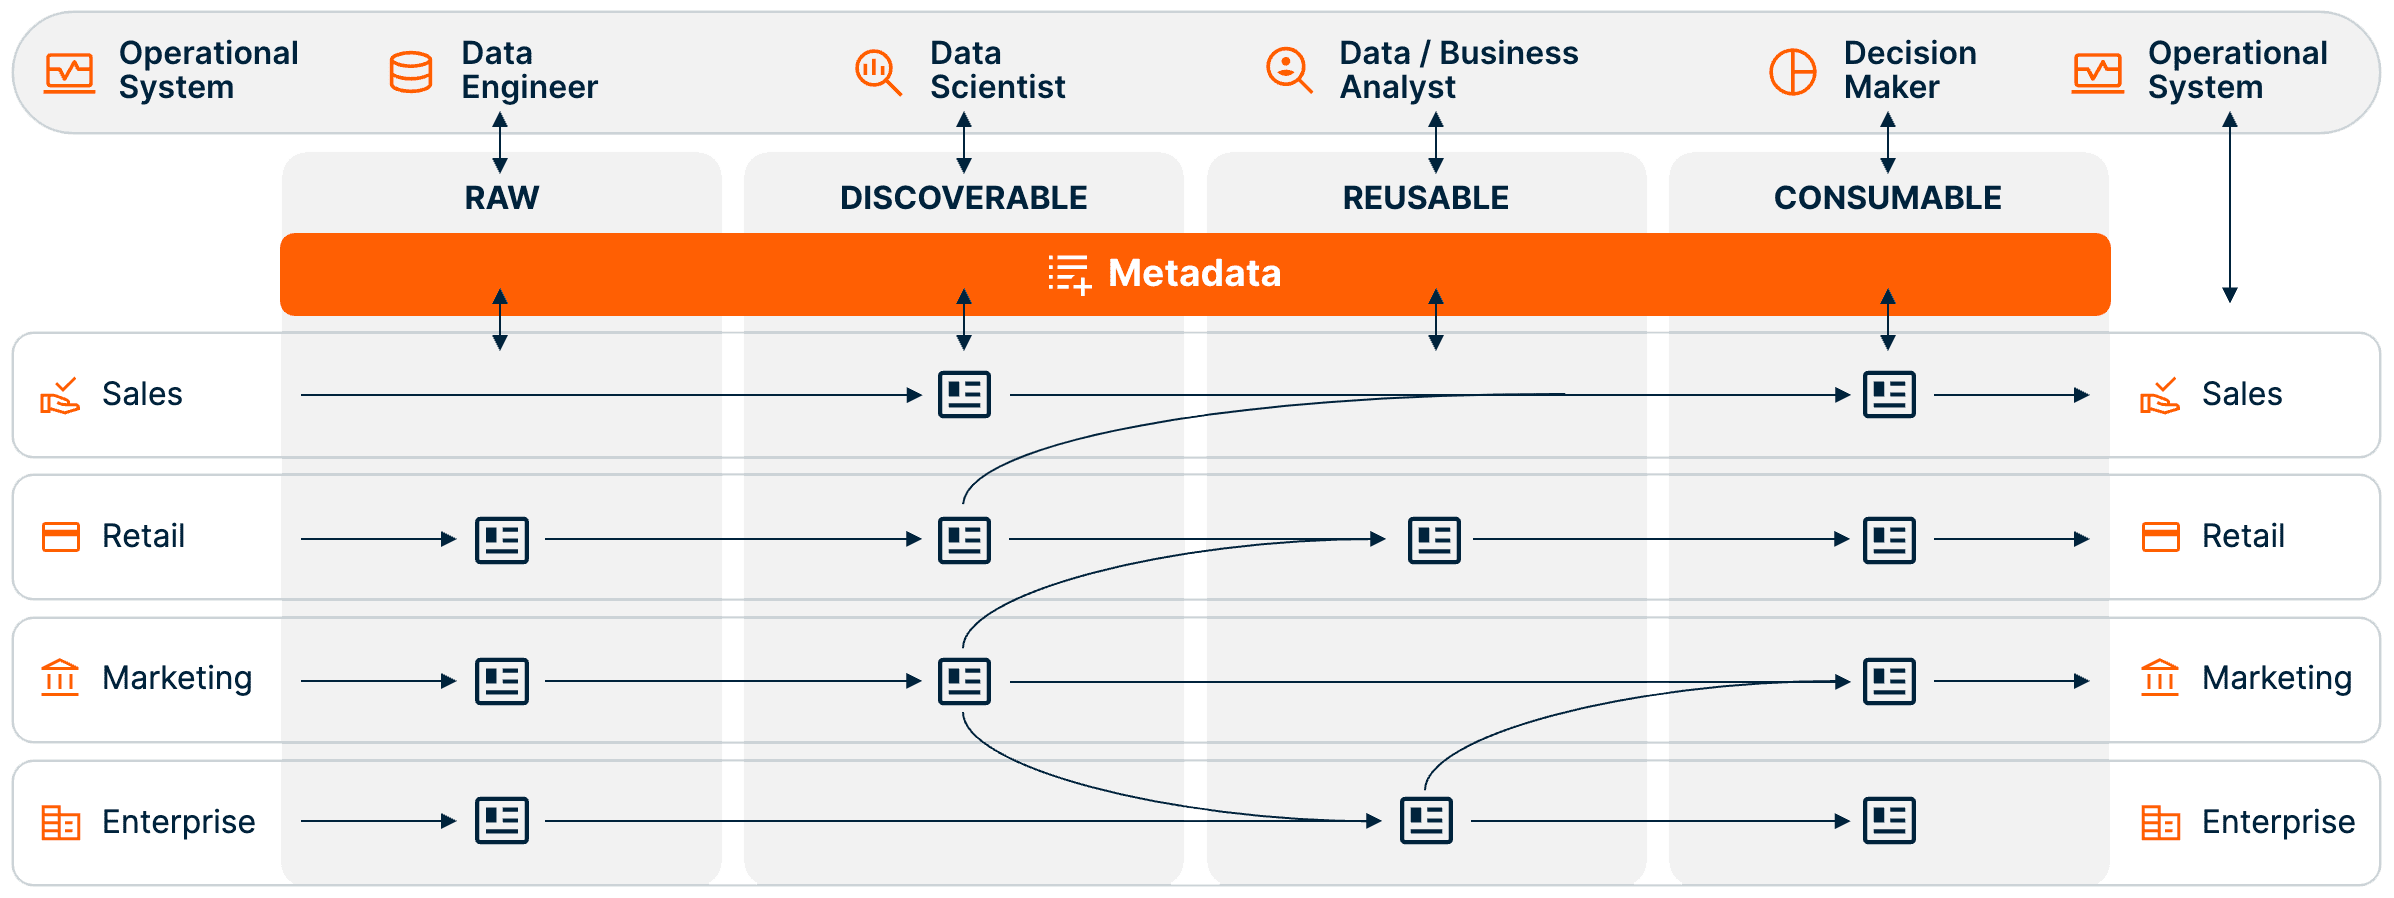
すべてのデータを元の形式のまま活用し、データ探索とコラボレーションを促進します。
Teradataは、論理リポジトリ内にあらゆる種類の非構造化データ、半構造化データ、構造化データを探索・変換するための理想的なプラットフォームを提供します。このリポジトリでは、パフォーマンスやデータの「温度」に応じて、データがオープン形式または最適化された形式で格納されます。
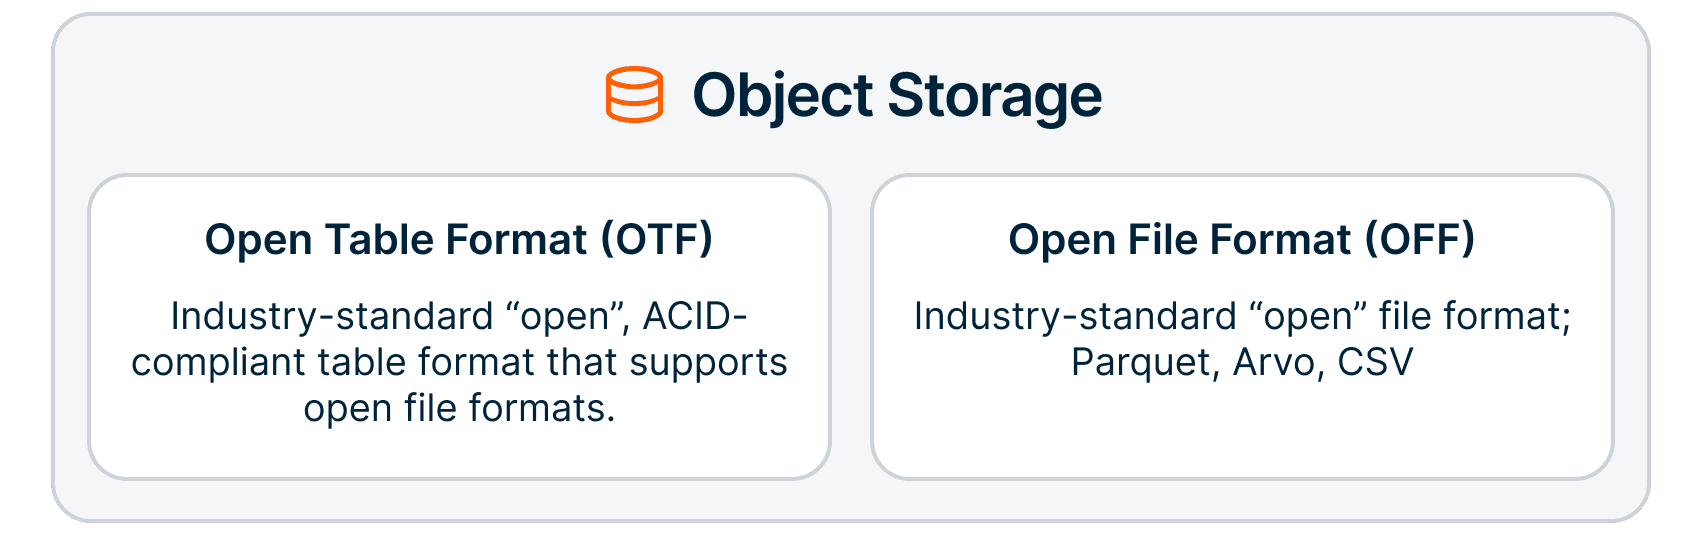
あらゆる場所からのデータを格納可能です。Teradataでは、オープンファイルフォーマットおよびオープンテーブルフォーマットでのデータ格納が可能です。
Teradataは、マルチクラウドおよびマルチデータレイク環境において、データストア、カタログ、クラウドサービスプロバイダ(CSP)からなるオープンエコシステムを幅広くサポートします。業界標準に基づくオープンデータストアは、AIエコシステム内のすべてのユーザーやテクノロジーに対して、処理性能とアクセスの圧倒的な柔軟性を提供。データ移動を最小限に抑え、システムの複雑性を排除することで、企業がインフラ管理の負担から解放され、データからビジネス価値を引き出すことに集中できるように支援します。
Rawデータからキュレーション済みデータ、構造化から非構造化データまで、全社のイノベーターが必要とするフォーマットで単一プラットフォームから自在にアクセス
全社のイノベーターが、統合プラットフォームからデータへ容易にアクセス・接続可能。既存のデータ製品上での部門間協働やセルフサービス環境での再利用を促進し、業務効率化と持続的なイノベーションを後押しします。